

原创 "AI能力库"大洗牌!GPT-5.6-Sol攻防能力首超Mythos,开源模型追得有多猛?
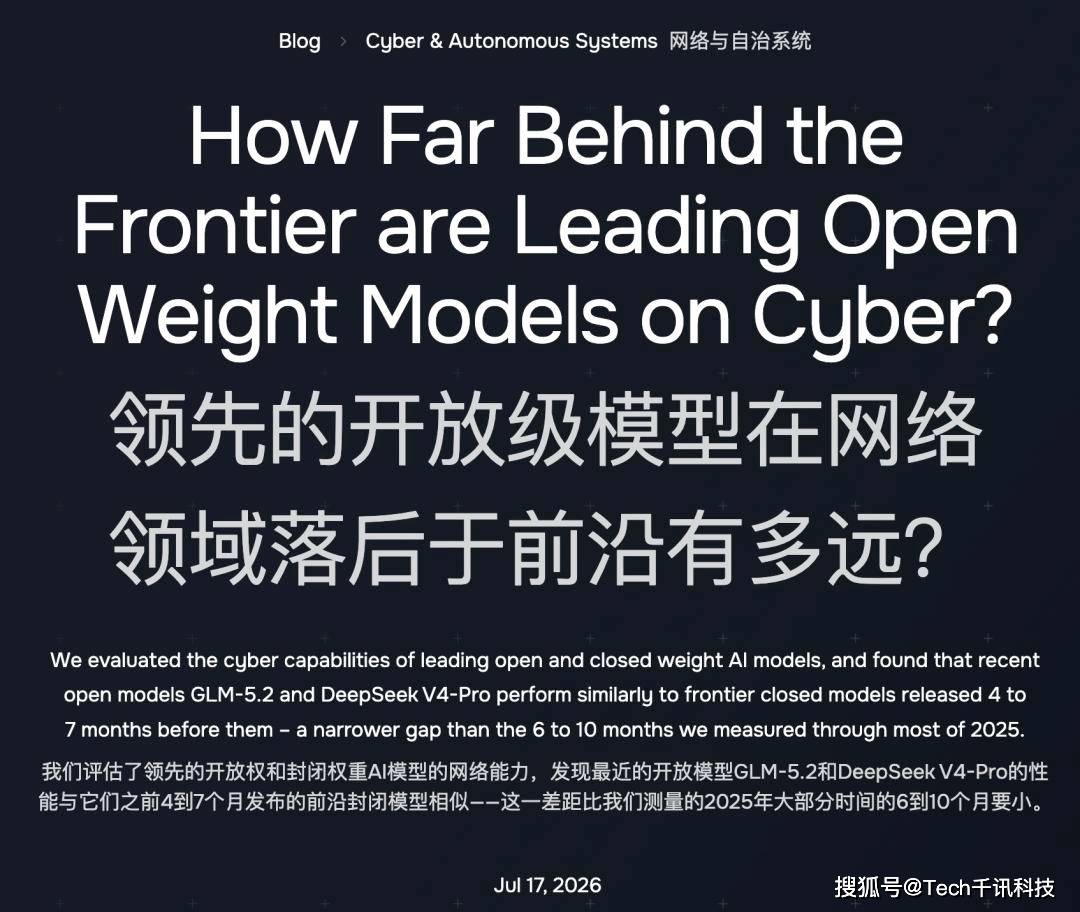
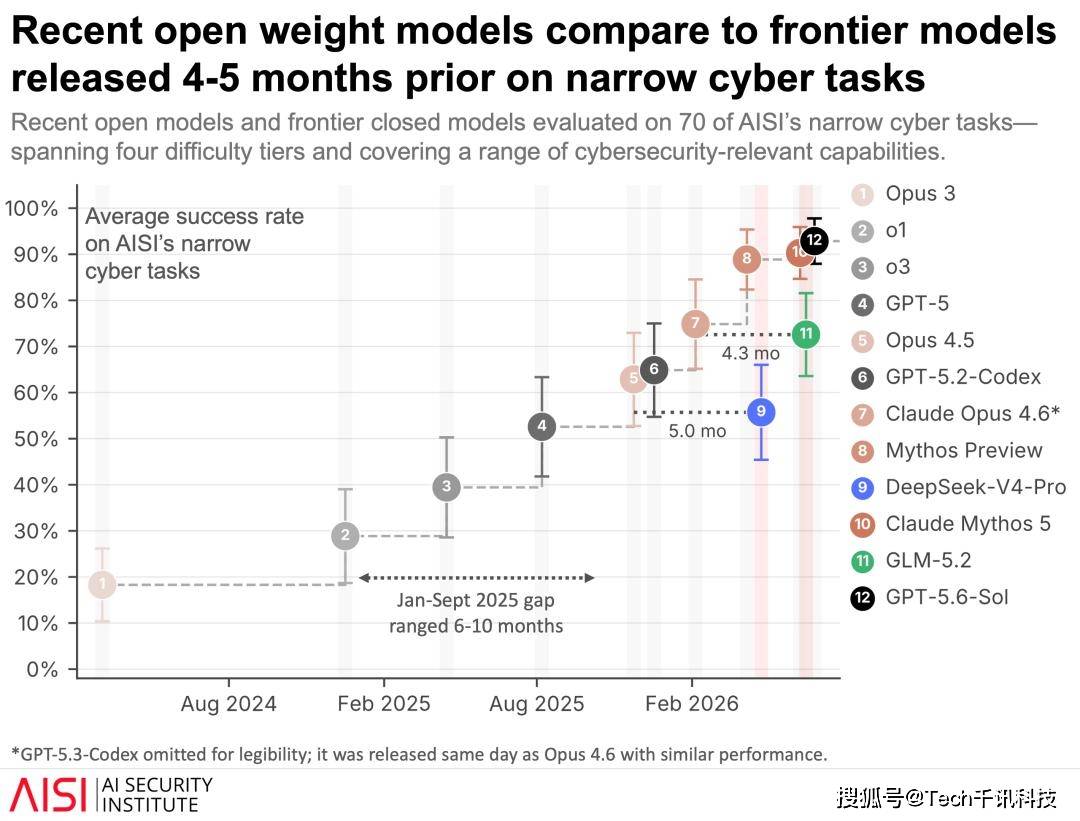
7月17日,英国伦敦电——全球AI领域的"军备竞赛"又掀开了新的一页。英国人工智能安全研究所(AISI)在7月17日发布的一份最新评估报告中,首次公开量化了一个令业界吃惊的趋势:开源AI模型与闭源顶级模型在网络攻击能力上的差距,已经从去年的6到10个月,急剧缩小到了4到7个月。
更引人注目的是,GPT-5.6-Sol——OpenAI于今年6月底发布的最新旗舰模型——在网络安全攻防能力上,已经超过了此前公认的"天花板"Anthropic的Claude Mythos 5。换句话说,攻防能力的顶尖排名,换了人。
防御窗口在缩小,攻击速度在翻倍
AISI的数据让人睡不着觉。就在今年4月,Mythos Preview和GPT-5.5在AISI的同类测试中,还创下了自2023年开测以来最大的一次网络攻击能力飞跃,多国政府纷纷拉响警报。当时报告显示,前沿AI模型的自主网络攻防能力翻倍周期,已经从过去的几年、几个月,压缩到了惊悚的4.5个月。
AISI使用两套测试体系对AI的网络攻击能力进行"体检"。第一套是70项窄任务,覆盖漏洞研究、逆向工程、Web渗透和密码学四大方向,分四个难度等级。第二套叫CyberRange,在模拟的企业内网中测试AI自主发动多步骤攻击的能力。其中最变态的一个测试场景叫"The Last Ones",包含32个攻击步骤、4个子网、大约20台主机。AISI估算,一名人类专家要完成全套动作,大概需要20个小时。
而两套方法给出的结论一致:开源模型正在拼命追赶,且"咬住"了。
开源猛追:能力差距缩小,成本差距更大
这份报告最具冲击力的数据,或许不是模型能力的得分,而是账本。
AISI的测试显示,在Cyber Range同一场测试中(消耗1亿Token额度),Anthropic的闭源旗舰Opus 4.5或4.6跑一次大约需要85美元;中国的开源模型GLM-5.2(今年6月发布)只需要大约46美元;而同样开源、性能强劲的DeepSeek V4-Pro,跑一次竟然只需要1.19美元。
换句话说,在能力逐渐追平的同时,开源模型的成本已经降到闭源产品的几十到几十分之一。在那些双方都能100%完成的任务上,Opus 4.6每个任务花费15.17美元,而GLM-5.2只要6.12美元。
GLM-5.2今年6月发布并开源后,在多项编程和长任务基准中表现已经介于Claude Opus 4.7和4.8之间,是当前全球最强的开源编码模型之一。AI研究机构Proximal也评价说,GLM-5.2是"第一个真正缩小了Anthropic和OpenAI与其他模型之间巨大技术鸿沟的模型"。
"闭源等于安全"的神话也被打破了
如果说开源免费大模型的追赶还只是"压力",那么Anthropic自家闭源旗舰Fable 5的翻车,则直接戳破了"闭源等于安全"这个泡泡。
AISI报告披露了一个极其戏剧性的案例:Anthropic的Fable 5于今年6月9日发布,仅仅三天后,安全研究员Pliny the Liberator就通过一个多步"越狱"策略,突破了它的安全分类器。相关截图显示,模型产出了本该被拦截的漏洞利用代码。随后,亚马逊的研究员也独立报告了另一种绕过方法。

这件事直接触发了美国商务部首个针对AI模型的出口管制令——Fable 5和Mythos 5全球被迫停服长达19天,直到Anthropic部署了新的安全分类器才恢复上线。
当时Anthropic在声明中无奈地表示,美国政府以"国家安全"为由,要求禁止任何非美国公民(包括公司里自己的外籍员工)访问这两款模型。美国商务部直到7月1日才解除了这一管制令。
AISI在报告中留下了一句话,点明了问题的结构性困境——"一旦开源释出,这些选项(指安全护栏和出口管制)永久丧失"。
攻防两端都被加速,但速度不一样
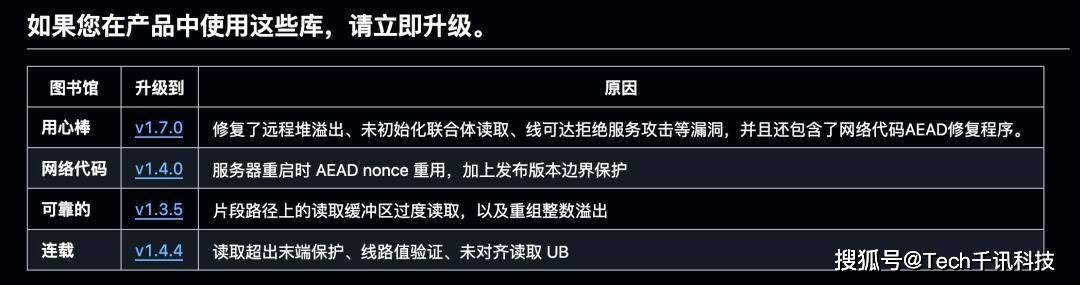
AI不仅能"破门",也能"修门"。报告同时举了一个正面的例子:知名游戏网络编程专家Glenn Fiedler,最近用Claude Code对自己维护的四个开源网络库做了系统性安全审计。他部署了自动化测试工具、进行了数百万次压力测试和逐行代码审查。结果令人心惊:两周内修复了43个安全漏洞,其中27个可以从网络远程触发;最严重的一个远程堆溢出漏洞,竟然在yojimbo库中潜伏了7年之久(自2019年起),恶意客户端只要构造一个特定的数据包就能触发。而整个审计的Token成本大约是2500美元。
攻防两端都在被AI加速,但加速的方式是不对称的。攻击能力的扩散是不可逆的——模型权重一旦释出,副本就可以在无人监管的私有服务器上跑。而防御工具的部署,却需要每个团队主动投入时间和成本。
闭源的"安全缓冲期"快要耗尽了
AISI这份报告对全球AI治理格局的影响,或许比数字本身更深远。开源与闭源的能力差距收窄到半年以内,"用闭源独占期充当安全缓冲"的默认策略,正迅速失效。与此同时,闭源模型的护栏在Fable 5事件中也同样脆弱。
报告释放了一个非常明确的政策信号:英国国家网络安全中心已经呼吁各机构加固网络安全基线,并利用AI来增强自身防御能力。对于全球决策者来说,下一阶段政策博弈的核心问题已经变得更加尖锐——"什么能力级别以上的模型,不应该开放权重?"
AISI表示,将继续推进这项评估。而在答案出来之前,攻与防的竞赛已经停不下来。